เหตุใดการกำกับดูแลข้อมูลแบบเดิม จึงไม่เพียงพอสำหรับระบบ AI?
ในโลกของการพัฒนาและประยุกต์ใช้เทคโนโลยีปัญญาประดิษฐ์ (AI) คำกล่าวที่ว่า “Data is the new oil” หรือ “Garbage in, Garbage out” ยังคงเป็นจริงเสมอ เพราะคุณภาพ ประสิทธิภาพ และความปลอดภัยของระบบ AI โดยเฉพาะระบบที่ใช้การเรียนรู้ของเครื่อง (Machine Learning: ML) ขึ้นอยู่กับชุดข้อมูลที่นำมาใช้ฝึกฝน (Training) ตรวจสอบ (Validation) ทดสอบ (Test) และประมวลผลจริง (Production)
การกำกับดูแลข้อมูลแบบดั้งเดิม (Traditional Data Governance) มักมุ่งเน้นไปที่การจัดเก็บข้อมูล การควบคุมการเข้าถึง และการปฏิบัติตามกฎหมายคุ้มครองข้อมูลส่วนบุคคล แต่การกำกับดูแลข้อมูลสำหรับระบบ AI (Data Governance for AI) มีความซับซ้อนกว่านั้นหลายเท่า เนื่องจากข้อมูลไม่ได้เป็นเพียงข้อมูลดิบที่จัดเก็บในระบบ แต่เป็นองค์ประกอบหลักที่หล่อหลอมพฤติกรรม การตัดสินใจ และความแม่นยำของอัลกอริทึม
หากองค์กรขาดการกำกับดูแลข้อมูล AI ที่รัดกุม อาจนำไปสู่ปัญหาอคติทางสถิติ (Bias) การสร้างผลลัพธ์ที่ไม่เป็นธรรม การเผชิญภัยคุกคามไซเบอร์เฉพาะทาง เช่น การวางยาข้อมูล (Data Poisoning) การละเมิดลิขสิทธิ์ข้อมูล หรือการที่ระบบ AI ทำงานผิดพลาดในสภาพแวดล้อมจริง
เพื่อแก้ปัญหาเหล่านี้ ISO/IEC 42001:2023 มาตรฐานระบบการจัดการปัญญาประดิษฐ์ (AIMS) จึงได้กำหนดวัตถุประสงค์และมาตรการควบคุมอ้างอิงใน Annex A.7 (Data for AI systems) ควบคู่กับแนวทางปฏิบัติตาม Annex B.7 เพื่อให้องค์กรใช้เป็น Checklist ในการจัดทำกระบวนการกำกับดูแลข้อมูล AI ตลอดวงจรชีวิตอย่างเป็นระบบและน่าเชื่อถือ
เจาะลึก Checklist การกำกับดูแลข้อมูลสำหรับ AI ตาม ISO/IEC 42001
ทำความรู้จักเป้าหมายการกำกับดูแลข้อมูล AI ตาม Annex A.7
ข้อกำหนด Annex A.7 (Data for AI systems) มีเป้าหมายหลักคือ “เพื่อให้องค์กรเข้าใจบทบาทและผลกระทบของข้อมูลในระบบ AI ทั้งในการประยุกต์ใช้ การพัฒนา การจัดหา หรือการใช้งานระบบ AI ตลอดวงจรชีวิต”
การบริหารจัดการข้อมูลตาม Annex A.7 ไม่ได้จำกัดอยู่เพียงขั้นตอนการสร้างโมเดล แต่ครอบคลุมตั้งแต่การกำหนดกลยุทธ์ข้อมูล การจัดหา การตรวจสอบคุณภาพ การบันทึกที่มา ไปจนถึงการตระเตรียมข้อมูลก่อนนำไปใช้งาน
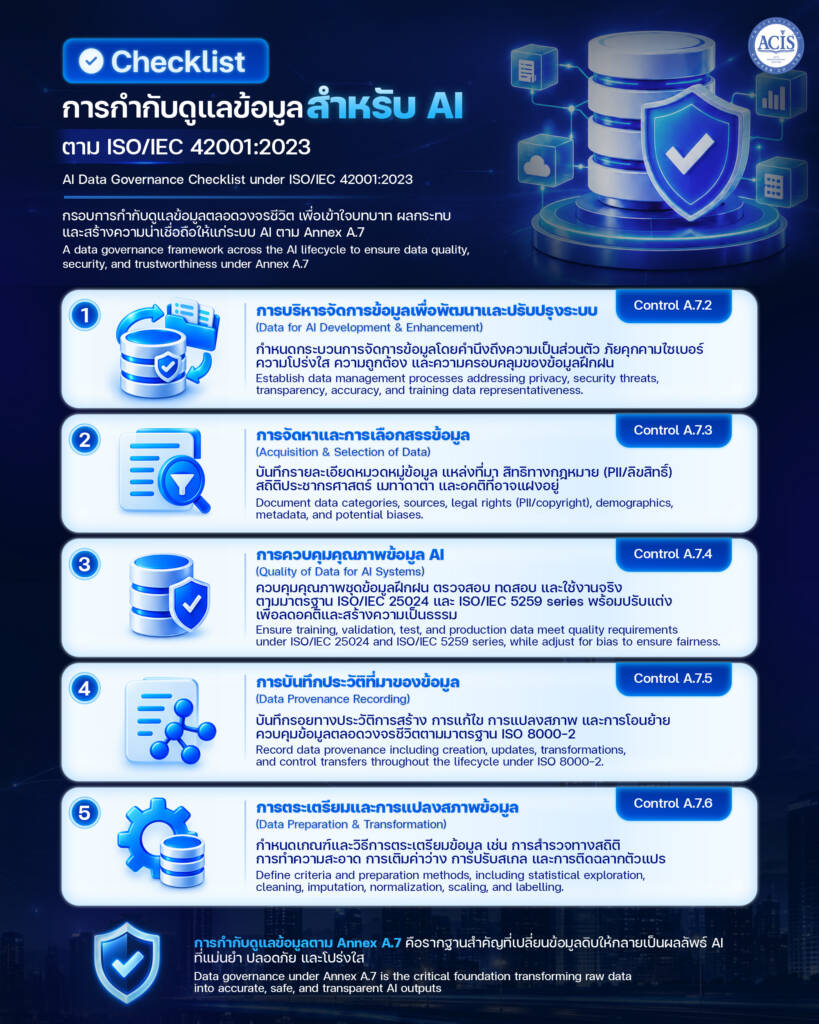
Checklist 5 ขั้นตอนหลักในการกำกับดูแลข้อมูลสำหรับ AI (Annex A.7.2 – A.7.6)
1. การบริหารจัดการข้อมูลเพื่อการพัฒนาและปรับปรุงระบบ (Data for Development and Enhancement – Control A.7.2 & Annex B.7.2)
องค์กรต้องกำหนด จัดทำเอกสาร และปรับใช้กระบวนการบริหารจัดการข้อมูลที่เกี่ยวข้องกับการพัฒนาระบบ AI โดยมีประเด็นที่ต้องตรวจสอบดังนี้:
- ประเมินผลกระทบด้านความเป็นส่วนตัวและความมั่นคงปลอดภัย: พิจารณาความเสี่ยงจากการใช้ข้อมูลที่มีความอ่อนไหว (Sensitive Data)
- วิเคราะห์ภัยคุกคามไซเบอร์เฉพาะตัว: ระบุภัยคุกคามที่อาจเกิดขึ้นจากการพัฒนา AI ที่พึ่งพาข้อมูล เช่น Data Poisoning
- สร้างความโปร่งใสและการอธิบายได้ (Transparency & Explainability): กำหนดกระบวนการที่สามารถอธิบายได้ว่า ข้อมูลถูกนำไปใช้ในการตัดสินใจและสร้างผลลัพธ์ของระบบ AI อย่างไร
- ตรวจสอบความเป็นตัวแทนของสภาพแวดล้อมจริง (Representativeness): ตรวจสอบว่าชุดข้อมูลฝึกฝนมีความครอบคลุมและสะท้อนบริบทของสภาพแวดล้อมที่จะนำระบบไปใช้งานจริง
- รักษาความถูกต้องและครบถ้วนของข้อมูล (Data Accuracy & Integrity): ควบคุมไม่ให้ข้อมูลถูกแก้ไข บิดเบือน หรือสูญหายระหว่างกระบวนการ
2. การจัดหาและการเลือกสรรข้อมูล (Acquisition of Data – Control A.7.3 & Annex B.7.3)
องค์กรต้องกำหนดและจัดทำเอกสารรายละเอียดเกี่ยวกับการจัดหาและการเลือกใช้ข้อมูลในระบบ AI อย่างชัดเจน ประกอบด้วย:
- ระบุหมวดหมู่ ปริมาณ และแหล่งที่มา: บันทึกประเภทข้อมูล ปริมาณที่ต้องใช้ และแหล่งที่มาของข้อมูล (เช่น ข้อมูลภายในองค์กร ข้อมูลจัดซื้อ ข้อมูลแบ่งปัน Open Data หรือ ข้อมูลสังเคราะห์ / Synthetic Data)
- วิเคราะห์ลักษณะของแหล่งข้อมูล: ระบุว่าเป็นข้อมูลแบบ Static, Streamed, Gathered หรือ Machine-generated
- ประเมินความเสี่ยงด้านอคติและสถิติประชากร: วิเคราะห์ข้อมูลประชากรของเจ้าของข้อมูล (Data Subject Demographics) เพื่อค้นหาอคติที่อาจแฝงอยู่ (Known or Potential Biases)
- ตรวจสอบประวัติการจัดการข้อมูลเดิม: ตรวจสอบว่าข้อมูลเคยผ่านการใช้งานอย่างไร และสอดคล้องกับข้อกำหนดความเป็นส่วนตัวและความปลอดภัยหรือไม่
- ตรวจสอบสิทธิในข้อมูล (Data Rights): ยืนยันสิทธิทางกฎหมายในการนำข้อมูลมาใช้งาน เช่น การคุ้มครองข้อมูลส่วนบุคคล (PII) และสิทธิในทรัพย์สินทางปัญญาหรือลิขสิทธิ์ (Copyright)
- บันทึก เมทาดาตา (Metadata): บันทึกข้อมูลกำกับเกี่ยวกับการติดฉลากข้อมูล (Data Labelling) และการยกระดับคุณภาพข้อมูล
3. การควบคุมคุณภาพข้อมูลสำหรับระบบ AI (Quality of Data for AI Systems – Control A.7.4 & Annex B.7.4)
คุณภาพข้อมูลส่งผลกระทบโดยตรงต่อความถูกต้องของผลลัพธ์ AI โดยมาตรฐานกำหนดให้องค์กรต้องระบุข้อกำหนดคุณภาพข้อมูลและควบคุมให้เป็นไปตามเกณฑ์:
- ครอบคลุมข้อมูลทุกหมวดหมู่ของ Machine Learning: กำหนดและวัดผลคุณภาพข้อมูลให้ครอบคลุมทั้ง ข้อมูลฝึกฝน (Training Data), ข้อมูลตรวจสอบ (Validation Data), ข้อมูลทดสอบ (Test Data) และข้อมูลใช้งานจริง (Production Data)
- อิงตามมาตรฐานสากล: นิยามคุณภาพข้อมูลตามมาตรฐาน ISO/IEC 25024 (ระดับที่ลักษณะของข้อมูลตอบสนองความต้องการตามบริบทการใช้งาน) และศึกษาแนวทางเพิ่มเติมจากมาตรฐานซีรีส์ ISO/IEC 5259
- ประเมินและปรับลดอคติ (Bias Adjustment): พิจารณาผลกระทบของอคติต่อประสิทธิภาพและความเป็นธรรม (Fairness) ของระบบ พร้อมทำการปรับแต่งโมเดลและชุดข้อมูลให้มีระดับความยอมรับได้ตาม Use Case
4. การบันทึกประวัติที่มาของข้อมูล (Data Provenance – Control A.7.5 & Annex B.7.5)
ความสามารถในการตรวจสอบย้อนกลับ (Traceability) เป็นหัวใจสำคัญของความน่าเชื่อถือ องค์กรต้องจัดทำกระบวนการบันทึกประวัติที่มาของข้อมูลตลอดวงจรชีวิตของข้อมูลและระบบ AI:
- บันทึกประวัติการเปลี่ยนแปลง (ISO 8000-2): จัดทำรอยทางเอกสาร (Audit Trail) บันทึกการสร้าง การอัปเดต การคัดลอก การสรุปความ การตรวจสอบความถูกต้อง และการเปลี่ยนผู้ควบคุมข้อมูล
- บันทึกการแบ่งปันและการแปลงสภาพ: บันทึกข้อมูลการแชร์ข้อมูลโดยไม่เปลี่ยนผู้ควบคุม รวมถึงกระบวนการแปลงสภาพข้อมูล (Data Transformations)
- ตรวจสอบยืนยันที่มา: จัดให้มีมาตรการตรวจสอบความถูกต้องของประวัติที่มาของข้อมูลตามระดับความเสี่ยงและบริบทการใช้งาน
5. การตระเตรียมและการแปลงสภาพข้อมูล (Data Preparation – Control A.7.6 & Annex B.7.6)
ก่อนนำข้อมูลไปฝึกฝนโมเดล ข้อมูลจำเป็นต้องผ่านกระบวนการตระเตรียมที่เหมาะสม องค์กรต้องกำหนดเกณฑ์และวิธีการตระเตรียมข้อมูลไว้อย่างเป็นลายลักษณ์อักษร:
- วิเคราะห์ข้อมูลเชิงสถิติ (Statistical Exploration): สำรวจการกระจายตัว ค่าเฉลี่ย ค่ามัธยฐาน ส่วนเบี่ยงเบนมาตรฐาน การแบ่งชั้น (Stratification) และการสุ่มตัวอย่าง (Sampling)
- การทำความสะอาดข้อมูล (Data Cleaning): แก้ไขข้อมูลที่ผิดพลาด และจัดการกับข้อมูลที่ขาดหาย
- การแทนที่ข้อมูลที่ขาดหาย (Imputation): กำหนดระเบียบวิธีในการเติมเต็มช่องว่างของข้อมูลอย่างมีหลักการ
- การปรับมาตรฐานและปรับสเกล (Normalization & Scaling): ปรับขนาดและสเกลของข้อมูลให้อยู่ในกรอบที่อัลกอริทึมประมวลผลได้ถูกต้อง
- การติดฉลากและการแปลงรหัส (Labelling & Encoding): กำหนดหลักเกณฑ์การติดฉลากตัวแปรเป้าหมาย และการแปลงข้อมูลกลุ่ม (Categorical Data) ให้เป็นตัวเลข
สรุปประเด็นสำคัญของการกำกับดูแลข้อมูล AI ตาม Annex A.7
- ครอบคลุมตลอดวงจรชีวิต (Control A.7.2): กำกับดูแลข้อมูลตั้งแต่การพัฒนาระหว่างทางจนถึงการใช้งานจริง โดยคำนึงถึงความปลอดภัย ความโปร่งใส และอคติ
- ตรวจสอบสิทธิ์และที่มา (Control A.7.3): บันทึกแหล่งที่มา สิทธิ์ลิขสิทธิ์ สิทธิ์ PII ประชากรศาสตร์ และเมทาดาตาในการจัดหาข้อมูลทุกครั้ง
- วัดผลคุณภาพข้อมูลทุกชุด (Control A.7.4): กำหนดเกณฑ์คุณภาพข้อมูลสำหรับ Training, Validation, Test และ Production Data ตามมาตรฐาน ISO/IEC 25024
- สร้าง Traceability ด้วย Data Provenance (Control A.7.5): บันทึกประวัติการสร้าง ปรับปรุง แปลงสภาพ และถ่ายโอนข้อมูลตามแนวทาง ISO 8000-2
- กำหนดมาตรฐานการเตรียมข้อมูล (Control A.7.6): บันทึกหลักเกณฑ์การทำความสะอาด แทนที่ค่าว่าง ปรับสเกล ติดฉลาก และแปลงรหัสข้อมูลอย่างเป็นระบบ
Data Governance คือรากฐานสร้างความโปร่งใสและความน่าเชื่อถือให้ระบบ AI
การนำ Checklist การกำกับดูแลข้อมูลสำหรับ AI ตามมาตรฐาน ISO/IEC 42001 (Annex A.7 & Annex B.7) ไปปรับใช้ในองค์กร ไม่ใช่เพียงการปฏิบัติตามข้อบังคับทางกฎหมายหรือมาตรฐานสากลเท่านั้น แต่คือ “การลงทุนเชิงกลยุทธ์” ที่ช่วยปกป้ององค์กรจากความผิดพลาดของอัลกอริทึม ภัยคุกคามไซเบอร์ และการละเมิดจริยธรรม
เมื่อผู้บริหาร ทีม IT/Cybersecurity และทีม Data Science สามารถควบคุมและตรวจสอบย้อนกลับข้อมูลที่นำมาฝึกฝนและขับเคลื่อนระบบ AI ได้อย่างชัดเจนและตรวจสอบได้ องค์กรจะสามารถสร้างสรรค์นวัตกรรม AI ที่มีประสิทธิภาพสูง มีความแม่นยำ ปลอดภัย และได้รับความไว้วางใจจากผู้บริโภคและสังคมอย่างยั่งยืน